Menyeleksi ratusan atau ribuan lamaran kerja dalam satu periode membutuhkan kecepatan, tetapi keputusan yang terlalu cepat dapat mengurangi ketelitian. Tim rekrutmen harus menilai pengalaman, kompetensi, dan relevansi kandidat sambil menghadapi berkas dengan format serta pilihan istilah yang beragam. Dalam kondisi seperti ini, penyaringan CV manual dan sistem Applicant Tracking System (ATS) berbasis kata kunci dapat menghasilkan celah yang sulit terlihat.
Masalahnya bukan semata-mata pada kinerja staf rekrutmen atau keberadaan teknologi. Tantangannya terletak pada cara sistem konvensional menerjemahkan informasi kandidat menjadi keputusan awal. Jika proses hanya membaca kata atau atribut tertentu, kandidat yang kompeten tetapi menggunakan istilah berbeda dapat tersisih sebelum kemampuan mereka ditinjau lebih lanjut.
Ketika volume lamaran mengurangi ketelitian
Penyaringan awal berkas lamaran sering menjadi tahap paling administratif dalam rekrutmen. Penilai perlu memeriksa riwayat kerja, pendidikan, keahlian, dan pengalaman proyek secara berulang. Saat volume dokumen meningkat, perhatian dapat terbagi dan waktu untuk memahami konteks setiap kandidat menjadi lebih terbatas.
Situasi ini dapat memicu kelelahan kognitif. Penilai mungkin lebih mudah mengandalkan sinyal yang cepat dikenali, seperti nama institusi, jabatan sebelumnya, format CV, atau istilah tertentu. Sinyal tersebut belum tentu menggambarkan kemampuan kandidat secara utuh. Seorang pelamar dengan pengalaman yang relevan, misalnya, dapat menggunakan istilah berbeda untuk menjelaskan kompetensi yang sama.
Bias afinitas juga dapat muncul ketika penilaian dipengaruhi oleh kesamaan latar belakang, gaya komunikasi, atau pengalaman antara penilai dan kandidat. Bias ini tidak selalu disengaja, tetapi dapat mengurangi konsistensi keputusan dan membatasi keberagaman kandidat yang maju ke tahap berikutnya.
Kelemahan sistem ATS berbasis kata kunci
ATS dapat membantu mengatur dan menyaring berkas, tetapi pendekatan berbasis pencocokan kata kunci memiliki batasan mendasar. Sistem semacam ini dapat mencari istilah yang telah ditentukan dalam deskripsi pekerjaan, lalu menggunakan kecocokan tersebut sebagai salah satu dasar penyaringan.
Masalah muncul ketika kompetensi dijelaskan dengan sinonim, istilah industri yang berbeda, atau format riwayat hidup yang tidak biasa. Kandidat mungkin memiliki pengalaman yang relevan, tetapi tidak menuliskan frasa yang sama persis dengan deskripsi pekerjaan. Inilah yang dapat menghasilkan false negative: kandidat potensial dianggap tidak sesuai karena bukti kompetensinya tidak terbaca melalui aturan pencocokan literal.
Format juga berpengaruh. Informasi penting yang ditempatkan dalam struktur dokumen non-standar atau ditulis dengan narasi proyek dapat lebih sulit dipetakan jika sistem hanya mencari istilah tertentu. Akibatnya, efisiensi pada tahap awal dapat dibayar dengan risiko kehilangan kandidat yang seharusnya layak ditinjau.
Laporan Harvard Business School tentang hidden workers mencatat bahwa 88% eksekutif dan pemberi kerja yang disurvei mengakui sistem otomasi seleksi dapat secara tidak sengaja menggugurkan kandidat berkeahlian tinggi karena profil mereka tidak memenuhi parameter deskripsi pekerjaan secara persis. Temuan tersebut menunjukkan mengapa desain kriteria dan cara sistem membaca pengalaman kandidat perlu diperiksa secara kritis.
Keyword stuffing menciptakan sinyal yang menyesatkan
Ketergantungan pada kata kunci juga dapat mendorong perilaku optimasi dokumen. Pelamar yang memahami cara kerja penyaringan otomatis mungkin menambahkan istilah dari deskripsi pekerjaan berulang kali, meskipun pengalaman praktisnya belum tentu sejalan dengan kebutuhan posisi.
Praktik ini sering disebut keyword stuffing. Bagi tim rekrutmen, masalahnya bukan hanya bertambahnya dokumen yang perlu ditinjau, tetapi juga menurunnya kualitas sinyal yang digunakan pada tahap awal. Resume yang kaya kata kunci dapat terlihat relevan secara tekstual, sementara kandidat lain dengan pengalaman yang lebih sesuai dapat tidak terdeteksi karena menggunakan bahasa yang lebih natural atau berbeda.
Karena itu, jumlah kecocokan kata tidak seharusnya menjadi satu-satunya dasar keputusan. Sistem penyaringan perlu membantu penilai memahami hubungan antara pengalaman, proyek, keahlian, dan tuntutan pekerjaan.
Evaluasi semantik membaca makna di balik pengalaman
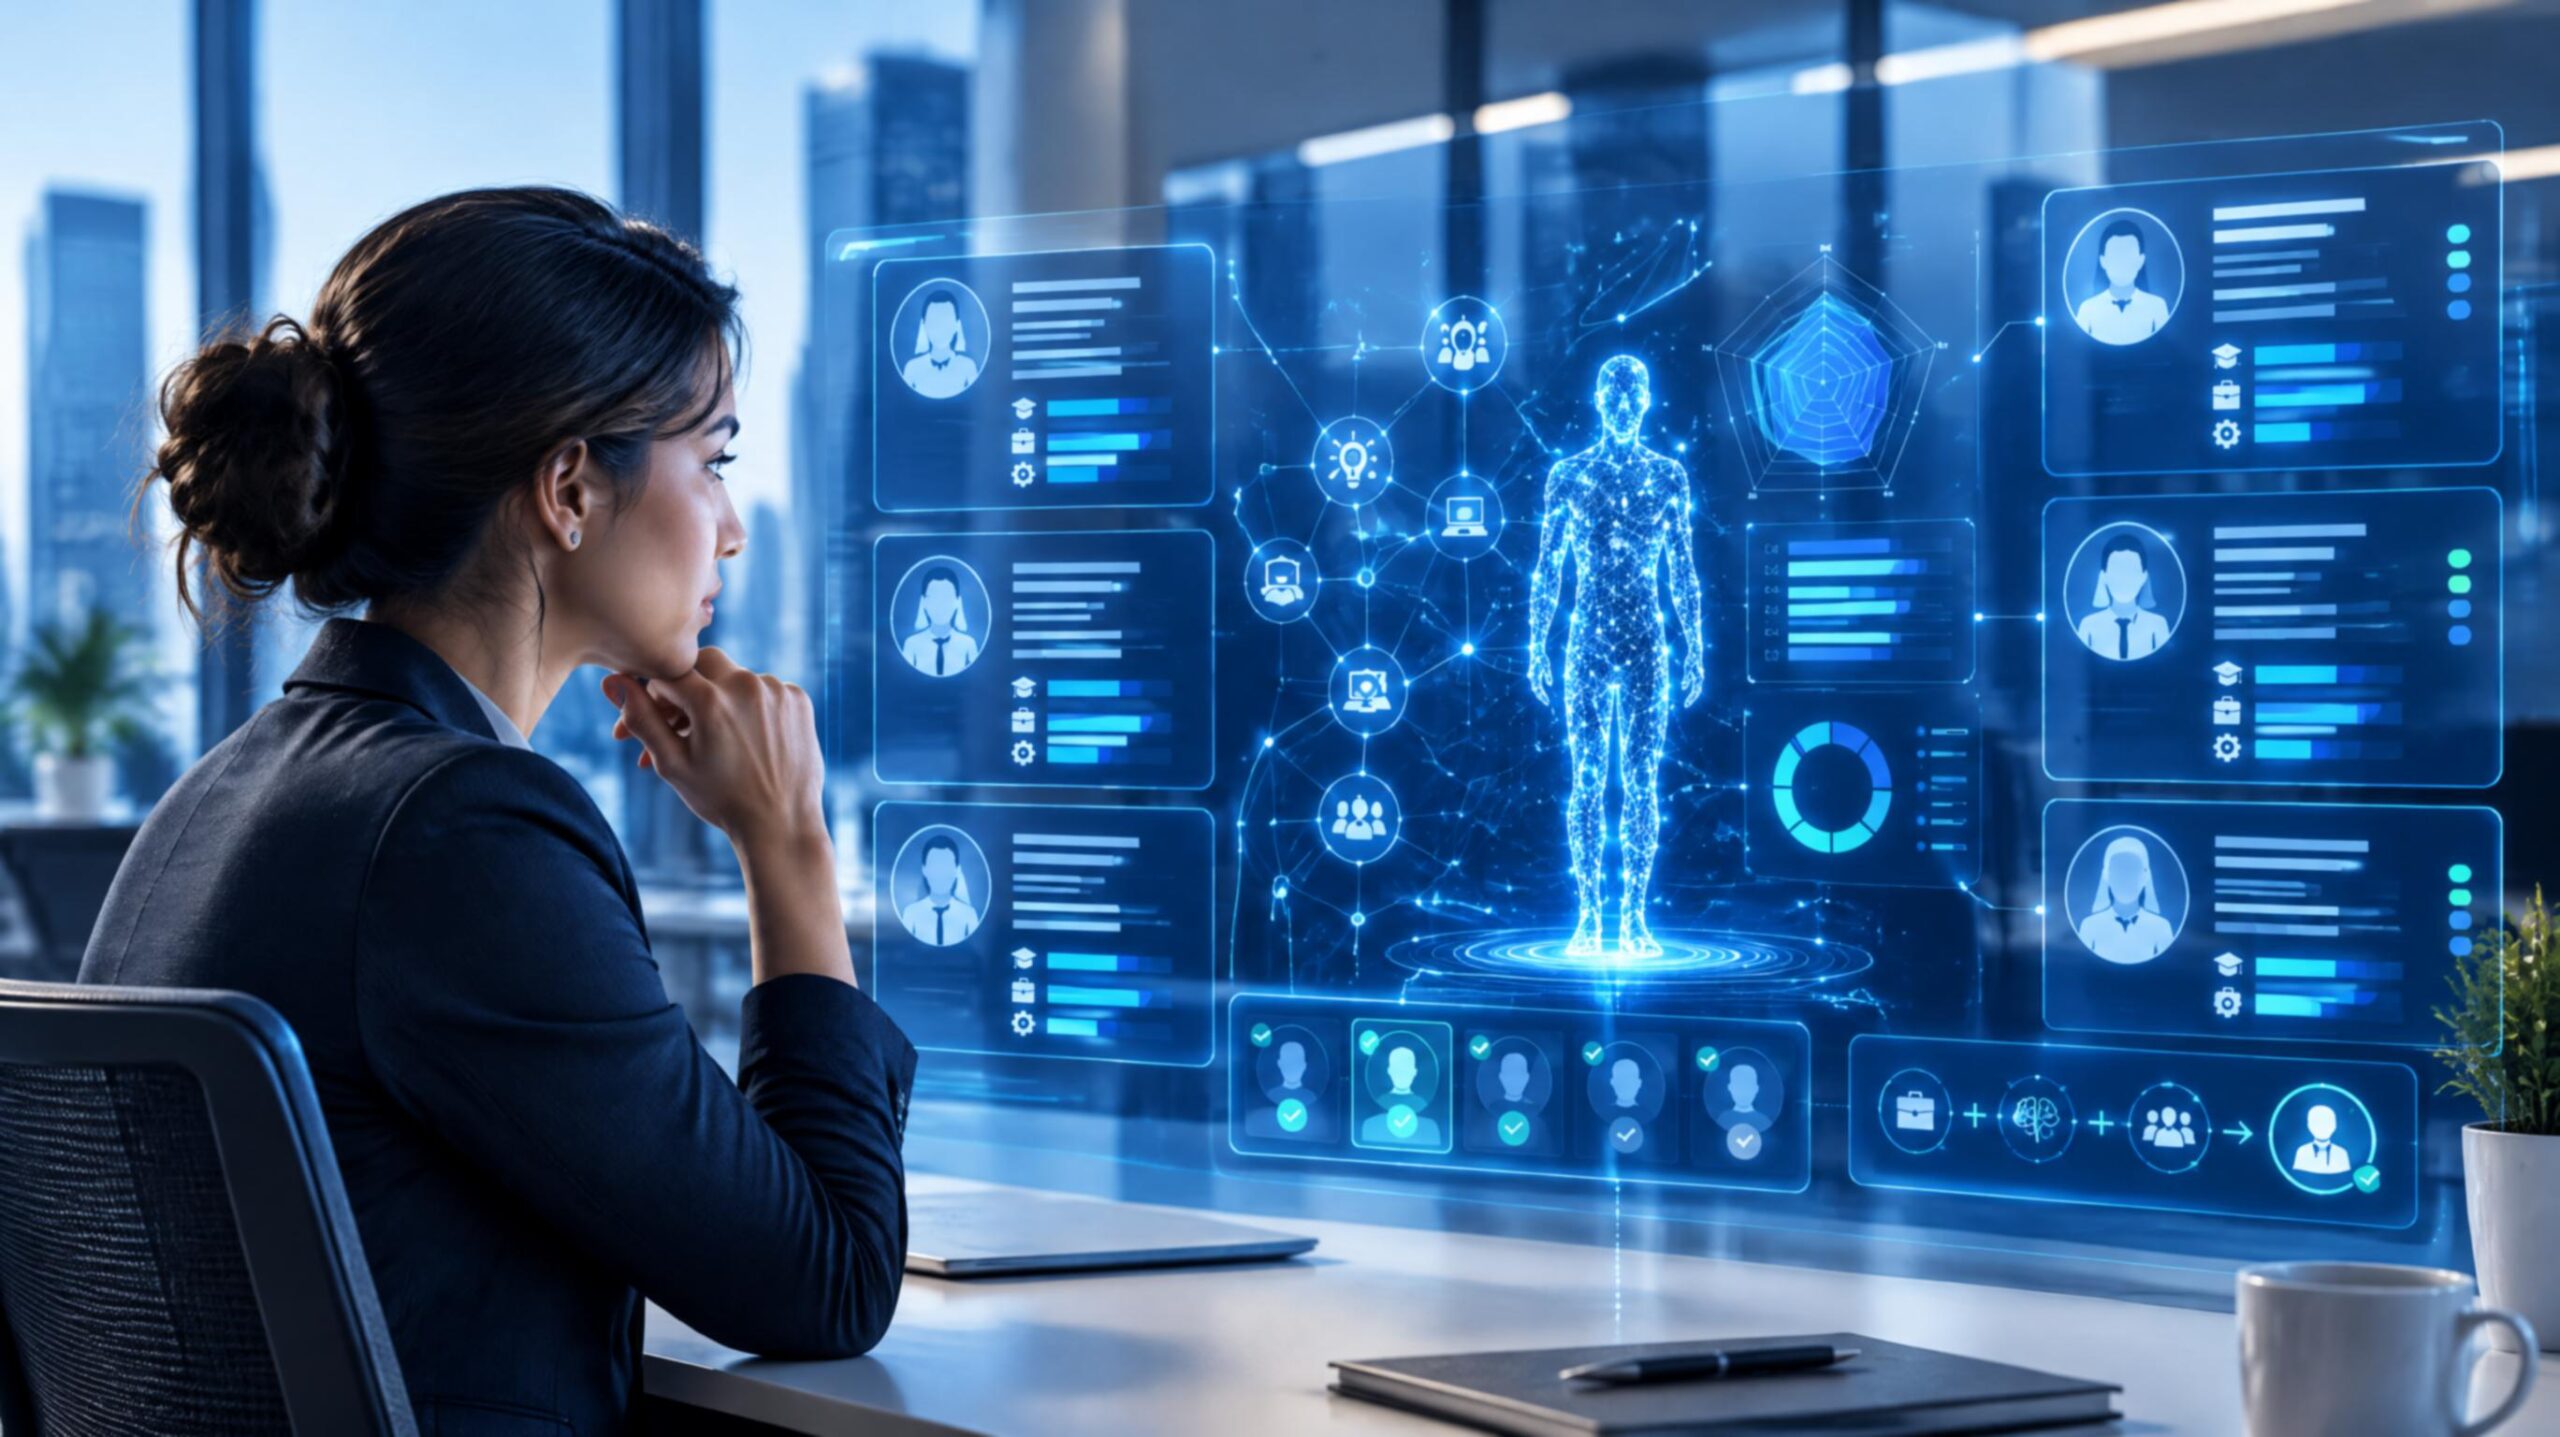
Pemrosesan bahasa alami (NLP) menawarkan pendekatan yang lebih kontekstual. Alih-alih hanya mencari frasa literal, analisis semantik berupaya memahami makna informasi dalam keseluruhan dokumen. Kompetensi dapat dipetakan berdasarkan hubungan antaristilah, konteks pengalaman, serta jenis pekerjaan atau proyek yang pernah dikerjakan.
Perbedaan ini penting ketika kandidat menjelaskan kemampuan melalui hasil kerja, tanggung jawab, atau pengalaman lintas fungsi. Sistem yang membaca konteks dapat membantu menghubungkan uraian tersebut dengan taksonomi keahlian yang relevan, meskipun kandidat tidak menggunakan kata yang sama persis dengan deskripsi pekerjaan.
Pendekatan semantik tidak berarti keputusan dapat dibuat tanpa peninjauan profesional. Hasil analisis sebaiknya digunakan untuk memperluas dan menstandarkan tahap penyaringan, sehingga tim dapat memeriksa kandidat berdasarkan bukti kompetensi yang lebih bermakna. Penilai tetap perlu memastikan bahwa kriteria yang digunakan sesuai dengan kebutuhan posisi dan tidak mengulang bias dari data atau aturan sebelumnya.
Dalam konteks ini, Metrik Peramalan Kontribusi menyediakan mesin pembaca riwayat hidup berbasis NLP dan analisis semantik kontekstual untuk membantu menilai informasi kandidat di luar pencocokan kata kunci sederhana. Relevansinya bagi tim rekrutmen terletak pada kemampuan untuk meninjau konteks keahlian dengan cara yang lebih terstruktur, bukan menggantikan pertimbangan manusia.
Blind screening untuk mengurangi bias pada tahap awal
Blind screening adalah metode penyaringan yang menyembunyikan informasi identitas tertentu agar penilaian awal lebih berfokus pada kompetensi yang relevan. Informasi seperti nama, usia, gender, atau latar belakang demografis dapat disamarkan atau dienkripsi sesuai rancangan proses dan kewajiban privasi organisasi.
Tujuan metode ini bukan menghapus seluruh kemungkinan bias dari proses rekrutmen. Namun, dengan mengurangi paparan terhadap atribut yang tidak berkaitan langsung dengan kemampuan kerja, tim dapat membangun tahap awal yang lebih konsisten. Penilai diarahkan untuk memperhatikan pengalaman, keahlian, dan bukti pekerjaan sebelum mempertimbangkan informasi identitas pada tahap yang memang diperlukan.
Blind screening juga perlu disertai kriteria yang jelas. Jika kriteria kompetensi tidak relevan, terlalu sempit, atau dibentuk dari data historis yang bias, penyamaran identitas saja tidak cukup. Organisasi perlu meninjau kriteria secara berkala dan memastikan keputusan dapat dijelaskan.
Untuk mendukung akuntabilitas, sistem juga sebaiknya menyediakan jejak logika komputasi dan transparansi inferensi algoritma. Tim rekrutmen perlu dapat memahami dasar suatu profil diprioritaskan atau disaring, kemudian menguji apakah hasilnya konsisten dengan kebutuhan posisi dan kebijakan organisasi. Metrik Peramalan Kontribusi memiliki modul blind screening dengan enkripsi identitas demografis serta pencatatan jejak logika komputasi yang dapat digunakan dalam kerangka proses tersebut.
Membangun proses rekrutmen yang lebih kontekstual
Peralihan dari penyaringan berbasis kata kunci ke evaluasi kontekstual sebaiknya dilakukan sebagai perbaikan proses, bukan sekadar penggantian perangkat. Tim akuisisi talenta dapat memulai dengan beberapa langkah:
- Petakan kompetensi inti. Pisahkan keahlian yang benar-benar diperlukan dari istilah yang hanya muncul karena kebiasaan penulisan deskripsi pekerjaan.
- Periksa kandidat yang tersaring. Tinjau sampel profil yang ditolak untuk melihat apakah ada pengalaman relevan yang tidak terbaca oleh aturan lama.
- Gunakan beberapa sumber bukti. Pertimbangkan konteks pengalaman dan hasil kerja, bukan hanya keberadaan kata tertentu.
- Uji keluaran sistem secara berkala. Bandingkan rekomendasi sistem dengan penilaian profesional dan periksa potensi pola bias.
- Dokumentasikan alasan keputusan. Transparansi membantu tim mengevaluasi proses dan menjelaskan keputusan kepada pemangku kepentingan.
Langkah-langkah tersebut menjaga teknologi tetap sebagai instrumen pendukung berbasis data. Sistem dapat membantu mengurangi pekerjaan administratif dan menyusun informasi secara lebih konsisten, sementara keputusan akhir tetap memerlukan penilaian profesional, konteks organisasi, dan pertimbangan etis.
Kesimpulan
Kelemahan sistem ATS terutama terlihat ketika pencocokan kata kunci diperlakukan sebagai gambaran lengkap tentang kompetensi kandidat. Pendekatan ini dapat melewatkan talenta yang menggunakan istilah berbeda, sementara keyword stuffing dapat meningkatkan visibilitas kandidat tanpa membuktikan kemampuan praktisnya. Penyaringan CV manual pun menghadapi risiko kelelahan kognitif dan bias bawah sadar ketika volume lamaran tinggi.
Evaluasi semantik berbasis NLP membantu membaca konteks pengalaman secara lebih menyeluruh, sedangkan blind screening dapat mengurangi pengaruh informasi demografis pada tahap awal. Jika keduanya diterapkan dengan kriteria yang relevan, pengujian berkala, dan jejak keputusan yang transparan, tim rekrutmen memiliki dasar yang lebih kuat untuk memperbaiki objektivitas proses.
Bagi organisasi yang sedang meninjau perangkat seleksinya, langkah berikutnya adalah memetakan bagian proses yang paling banyak menghasilkan pekerjaan manual atau kandidat yang tidak terbaca. Tinjau bagaimana Metrik Peramalan Kontribusi dapat mendukung pembacaan riwayat hidup berbasis konteks, blind screening, dan transparansi jejak logika dalam proses rekrutmen yang lebih terukur.
